Editorial
August 2026: Die Illusion des Sichtbaren in der Cyberstrategie
Ohne Licht kein Schatten. Das alte Sprichwort erscheint trivial. Im Kontext der Cybersicherheit offenbart es eine unangenehme strategische Wahrheit: Wir gehen davon aus, dass mehr Sichtbarkeit automatisch mehr Sicherheit schafft. Doch was, wenn jemand beeinflussen kann, was wir überhaupt sehen?
Der Schatten ist dann nicht mehr das eigentliche Problem. Entscheidend wird das Licht.
Moderne Sicherheitsarchitekturen basieren auf Sichtbarkeit. Logs werden gesammelt, Netzwerke überwacht, Datenströme analysiert und Ereignisse in SIEM-Systemen zusammengeführt. Was sichtbar wird, kann untersucht werden. Was verstanden wird, kann geschützt werden. Zumindest lautet so die verbreitete Annahme. Ein SIEM sieht nicht die Realität. Es sieht, was Sensoren erfassen, Systeme protokollieren, Pipelines transportieren, Parser verstehen, Regeln korrelieren und Analysten priorisieren. Dazwischen liegen Filter, Schwellenwerte und Annahmen. Sichtbarkeit ist deshalb keine neutrale Abbildung der Realität, sondern eine konstruierte Perspektive darauf.
Genau darin liegt eine strategische Schwachstelle.
Einem Angreifer genügt es nicht immer, unsichtbar zu bleiben. Manchmal ist es wirkungsvoller, zu beeinflussen, was sichtbar erscheint und wie das Sichtbare interpretiert wird. Eine legitime Authentifizierung, ein erwarteter API-Aufruf oder scheinbar normales Benutzerverhalten kann vollkommen sichtbar und trotzdem Teil eines Angriffs sein. Das Sicherheitssystem sieht die Aktivität. Es gibt ihr lediglich die falsche Bedeutung. Die Bedrohung steht damit nicht zwingend im Dunkeln. Sie kann mitten im Licht stehen.
Wer kontrolliert das Licht?
Social Engineering funktioniert nach einem ähnlichen Prinzip. Eine Nachricht überzeugt nicht, weil sie unsichtbar ist, sondern weil Absender, Sprache, Zeitpunkt und Kontext unseren Erwartungen entsprechen. Der Angreifer versteckt sich nicht vor unserer Wahrnehmung. Er nutzt sie.
Mit AI gewinnt dieser Gedanke zusätzlich an Bedeutung. Systeme helfen uns, immer grössere Informationsmengen zu verdichten, Zusammenhänge zu erkennen und Relevantes von vermeintlich Irrelevantem zu trennen. Das ist wertvoll. Gleichzeitig delegieren wir damit einen Teil unserer Wahrnehmungsselektion. Was wird hervorgehoben? Was bleibt im Hintergrund? Welche Zusammenhänge erscheinen relevant? Welche Informationen erreichen den Menschen überhaupt?
Mehr Telemetrie schafft deshalb nicht automatisch mehr Erkenntnis. Mehr Dashboards schaffen nicht automatisch mehr Überblick. Und mehr Alerts schaffen nicht automatisch mehr Sicherheit. Die strategisch interessantere Frage lautet nicht nur: Was können wir sehen? Sondern: Warum sehen wir genau das?
Zwischen dem, was tatsächlich geschieht, dem, was ein System davon sichtbar macht, und dem, was ein Mensch daraus versteht, liegt ein zunehmend wichtiger Raum. Und auf genau dieser Wahrnehmung basieren schliesslich unsere Entscheidungen.
Sicherheit bedeutet nicht, jeden Winkel auszuleuchten. Vollständige Sichtbarkeit ist in komplexen digitalen Umgebungen ohnehin eine Illusion. Entscheidend ist die Fähigkeit zu verstehen, wie unsere Sicht auf diese Umgebung entsteht und wer sie beeinflussen kann. Die gefährlichste Blindheit beginnt nicht dort, wo wir nichts sehen. Sie beginnt dort, wo wir dem Sichtbaren ungeprüft vertrauen.
Ohne Licht gibt es keinen Schatten. Doch auch das Licht selbst kann täuschen.
Cyberstrategie bedeutet nicht nur, mehr zu sehen. Sie bedeutet zu verstehen, wer bestimmt, was wir sehen, warum wir es sehen und was unsichtbar bleibt.
Herzlichen Dank für Ihre Treue als Leserschaft des scip monthly Security Summary. Viel Freude bei der Lektüre dieser Ausgabe.

AI Assurance by scip, Wir schaffen Vertrauen in Künstliche Intelligenz
Cybersecurity schützt Informationen | Trustworthy AI beschreibt die Prinzipien | AI Assurance schafft Vertrauen in Künstliche Intelligenz
Fachartikel
Aktuelle Erkenntnisse

Wir müssen lernen, Entscheidungen zu schützen.
Seit Jahrzehnten investieren Organisationen erhebliche Anstrengungen darin, Informationen zu schützen. Vertraulichkeit, Integrität und Verfügbarkeit bilden bis heute zentrale Grundlagen moderner Informationssicherheit. Zugriffe werden kontrolliert, Systeme gehärtet, Schwachstellen gesucht, Datenflüsse überwacht und Angriffe simuliert. Diese Arbeit bleibt notwendig.
Mit künstlicher Intelligenz verändert sich jedoch etwas Grundlegendes: Informationen werden zunehmend nicht mehr nur gespeichert, übertragen oder Menschen zur Beurteilung vorgelegt. AI-Systeme interpretieren Informationen, verdichten sie, gewichten Zusammenhänge, erstellen Empfehlungen und beeinflussen damit Entscheidungen. Agentische Systeme gehen noch einen Schritt weiter. Sie können Werkzeuge aufrufen, externe Systeme ansprechen und aus einer Empfehlung unmittelbar eine Aktion ableiten.
Damit verändert sich der relevante Betrachtungsraum. Nicht nur die Information selbst muss vertrauenswürdig sein. Auch die Entscheidung, die daraus entsteht, wird zum Schutz- und Vertrauensobjekt.
Wir bezeichnen diesen entstehenden Betrachtungsraum als Decision Security.
Informationen besitzen Wert. Entscheidungen schaffen Wirkung.
Eine Information allein verändert die Welt zunächst nicht. Wirkung entsteht erst durch Interpretation, Empfehlung, Entscheidung und Handlung. Ein Arzt beurteilt Untersuchungsergebnisse. Ein Unternehmen wählt einen Lieferanten. Eine Bank bewertet ein Risiko. Ein Security Operations Center entscheidet, ob eine Aktivität blockiert wird. Ein Management priorisiert Investitionen, Personal oder strategische Initiativen.
Zwischen Information und Wirkung liegt deshalb eine Kette. Diese Kette ist nicht neu. Neu ist, wie viele ihrer Bestandteile zunehmend durch AI beeinflusst oder teilweise übernommen werden. Ein Large Language Model kann Informationen interpretieren. Ein Retrieval-System ergänzt Kontext. Ein spezialisiertes Modell bewertet einen Sachverhalt. Ein Agent leitet daraus nächste Schritte ab. Weitere Systeme können diese direkt ausführen.
Die Distanz zwischen Information und Wirkung wird dadurch kleiner. Gleichzeitig wächst die Bedeutung der Frage, wie eine Entscheidung zustande gekommen ist, auf welchen Grundlagen sie beruht, welche Systeme sie beeinflusst haben und wer dafür Verantwortung trägt.
Genau deshalb sehen wir Entscheidungen künftig als eigenständiges Vertrauensobjekt.
Sichere Informationen reichen nicht mehr aus
Eine Organisation kann die Integrität ihrer Daten erfolgreich sicherstellen und trotzdem eine problematische Entscheidung treffen. Die Daten können korrekt, aber unvollständig sein. Ein Modell kann technisch korrekt funktionieren, aber ausserhalb seines vorgesehenen Kontexts eingesetzt werden. Eine Empfehlung kann plausibel erscheinen, obwohl relevante Gegeninformationen fehlen. Ein AI-System kann Unsicherheit ausdrücken, während die nachgelagerte Anwendung daraus eine scheinbar eindeutige Aussage macht. Und ein Mensch kann formal eine Empfehlung bestätigen, ohne realistisch beurteilen zu können, wie sie zustande gekommen ist. Für uns gilt:
Sichere Informationen und sichere Systeme sind notwendige Voraussetzungen für vertrauenswürdige Entscheidungen. Sie sind aber keine Garantie dafür.
Decision Security beginnt genau an dieser Stelle. Es betrachtet nicht nur die Sicherheit einzelner Komponenten, sondern die Vertrauenswürdigkeit des vollständigen Entscheidungsprozesses.
Diese breitere Perspektive findet sich auch in bestehenden Ansätzen zu Trustworthy AI. Das NIST Artificial Intelligence Risk Management Framework betrachtet AI-Risiken über Design, Entwicklung, Einsatz und Evaluation hinweg und versteht deren Management ausdrücklich als multidisziplinäre Aufgabe. Der Framework organisiert diese Aufgabe entlang der Funktionen Govern, Map, Measure und Manage und betrachtet Risk Management als kontinuierliche Tätigkeit über den AI Lifecycle hinweg.
Decision Security liegt ausserhalb einzelner Disziplinen
Decision Security ist keine neue Unterdisziplin der Cybersecurity. Cybersecurity ist ein wichtiger Bestandteil davon, aber nicht der übergeordnete Rahmen.
Cybersecurity beantwortet Fragen wie: Können Daten manipuliert werden? Ist ein Modell angreifbar? Sind Identitäten und Berechtigungen korrekt? Können Agenten oder Integrationen missbraucht werden? Diese Perspektive ist zentral, aber sie reicht allein nicht aus.
Eine Entscheidung kann problematisch sein, obwohl kein Cyberangriff stattgefunden hat. Vielleicht war die Datenbasis ungeeignet. Vielleicht wurde ein statistischer Zusammenhang falsch interpretiert. Vielleicht war Human Oversight formal vorgesehen, praktisch aber wirkungslos. Vielleicht fehlt eine klare Zuordnung der Verantwortung. Vielleicht ist der Prozess compliant und trotzdem schlecht geeignet, eine bestimmte Entscheidung zu unterstützen.
Decision Security liegt deshalb an der Schnittstelle von Cybersecurity, Governance, Human Factors, Risk Management, Data, AI Engineering und Assurance.
Das gemeinsame Schutzobjekt ist die Entscheidung.
Auch die OECD AI Principles verfolgen einen bewusst breiten Ansatz für Trustworthy AI. Sie verbinden unter anderem Human Agency and Oversight, Transparency and Explainability, Robustness, Security and Safety sowie Accountability. Besonders relevant für Decision Security ist die Forderung nach Traceability in Bezug auf Daten, Prozesse und Entscheidungen über den AI Lifecycle hinweg.
Das eigentliche System ist der Decision Flow
Wenn heute über AI gesprochen wird, konzentriert sich die Diskussion oft auf das Modell. Welches Modell wird eingesetzt? Wie gross ist es? Wie hoch ist seine Accuracy? Ist es proprietär oder Open Source? Wo wird es betrieben?
Für Decision Security reicht diese Betrachtung nicht. Relevant ist der vollständige Decision Flow. Ein Unternehmen nutzt beispielsweise einen AI-basierten Agenten zur Bewertung potenzieller Lieferanten. Die entscheidende Frage lautet dann nicht mehr: Ist das Modell sicher? Sie lautet: Ist der gesamte Entscheidungsfluss vertrauenswürdig?
Dazu gehört, welche Daten einfliessen, wie sie interpretiert werden, welche Modelle beteiligt sind, welche Unsicherheiten bestehen, wie ein Mensch eingebunden wird, wer Verantwortung trägt und welche Handlung aus der Entscheidung entsteht.
Nicht jede problematische Entscheidung braucht einen Angreifer
Cybersecurity denkt naturgemäss stark adversarial. Wer könnte etwas manipulieren und wie? Diese Perspektive bleibt wichtig. Decision Security erweitert sie jedoch um nicht-adversariale Ursachen.
Eine Entscheidung kann beeinträchtigt werden, weil Daten veraltet sind. Weil relevante Faktoren fehlen. Weil sich die Umwelt seit der ursprünglichen Validierung verändert hat. Weil ein organisatorischer Prozess falsche Anreize setzt. Weil ein Mensch ein System überschätzt. Oder weil das Ergebnis korrekt erzeugt, aber im falschen Kontext verwendet wird.
Decision Security beschäftigt sich deshalb sowohl mit Manipulation als auch mit Fehlentwicklung, Fehlinterpretation und Fehlanwendung.
Das macht den Betrachtungsraum breiter als klassische Security.
AI verändert gleichzeitig das Angriffsziel
Die offensive Perspektive bleibt trotzdem besonders spannend. Traditionell versuchen Angreifer häufig, Informationen oder Systeme zu kompromittieren. Sie wollen Daten auslesen, Code ausführen, Privilegien erweitern oder Kontrolle über eine Umgebung gewinnen.
Bei AI-gestützten Entscheidungsprozessen kommt ein weiteres Ziel hinzu: die Entscheidung selbst zu beeinflussen.
Ein Angreifer kann versuchen, Inhalte zu manipulieren, die später durch Retrieval als vertrauenswürdiger Kontext verwendet werden. Prompt Injection kann das Verhalten eines LLM-basierten Systems verändern. Poisoning kann Daten oder Modelle beeinflussen. Zu weitreichende Agentenberechtigungen können schliesslich dafür sorgen, dass aus einer manipulierten Interpretation unmittelbar reale Aktionen entstehen.
NIST beschreibt solche adversarialen Einflüsse in NIST Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations, NIST AI 100-2 E2025. Die Taxonomie behandelt Angriffe über unterschiedliche Phasen des Machine-Learning-Lebenszyklus und umfasst unter anderem Data Poisoning, Evasion und weitere Manipulationen von AI-Systemen.
Ergänzend betrachtet das OWASP Top 10 for LLM Applications 2026 Risiken moderner LLM-basierter Anwendungen, darunter Prompt Injection, Data and Model Poisoning, Vector and Embedding Weaknesses sowie Excessive Agency.
Damit kann eine Umgebung technisch weitgehend korrekt funktionieren. Identitäten sind gültig, APIs antworten, Berechtigungen sind formal korrekt und der Agent führt nur erlaubte Aktionen aus. Trotzdem wurde die Entscheidung erfolgreich beeinflusst. Der Decision Attack Path kommt als zusätzlicher Angriffspfad dazu.

Human Oversight ist mehr als ein Mensch im Prozessdiagramm
Ein häufig genannter Schutzmechanismus für AI-basierte Entscheidungen lautet Human in the Loop. Das klingt überzeugend, ist aber nur dann wirksam, wenn der Mensch tatsächlich beurteilen und eingreifen kann.
Dafür braucht er Kontext, Zeit, Kompetenz, Autorität und nachvollziehbare Informationen. Wenn ein Mitarbeiter täglich hunderte AI-Empfehlungen bestätigt, besteht zwar formal Human Oversight, praktisch kann daraus jedoch eine automatisierte Freigabe werden.
Für Decision Security ist deshalb nicht entscheidend, ob ein Mensch irgendwo im Prozess auftaucht. Entscheidend ist, ob wirksame menschliche Kontrolle tatsächlich vorhanden ist.
Der Mensch ist nicht die letzte Firewall eines AI-Systems. Er ist Teil des Entscheidungssystems.
Genau diese Unterscheidung wird auch regulatorisch relevant. Article 14 des EU AI Act Regulation EU 2024/1689 verlangt für High-Risk-AI-Systeme wirksame Human-Oversight-Möglichkeiten. Menschen sollen unter anderem relevante Fähigkeiten und Grenzen des Systems verstehen, Automation Bias berücksichtigen, Outputs interpretieren und abhängig vom System, eingreifen, Outputs ignorieren oder übersteuern beziehungsweise den Betrieb stoppen können.
Der AI Act definiert damit nicht Decision Security. Er zeigt aber deutlich, dass menschliche Aufsicht mehr bedeutet als die formale Anwesenheit eines Menschen im Entscheidungsprozess.
Trustworthy AI führt zwangsläufig zur Entscheidung
Internationale Frameworks und Standards zeigen bereits dieselbe Richtung, auch wenn sie Decision Security nicht als eigene Disziplin definieren.
Neben dem NIST AI RMF und den OECD AI Principles verfolgt ISO/IEC 42001:2023 einen organisationsweiten Ansatz für AI Management Systems. Der Standard definiert Anforderungen für Aufbau, Implementierung, Betrieb und kontinuierliche Verbesserung eines AI Management Systems und verbindet den verantwortungsvollen Einsatz von AI mit Governance und Risikomanagement.
Diese Entwicklungen zeigen für uns ein klares Muster:
AI Trustworthiness endet nicht beim Modell. Sie reicht bis in den Entscheidungsprozess hinein.
Je stärker AI reale Entscheidungen beeinflusst, desto wichtiger wird die Frage, ob dieser Prozess nachvollziehbar, kontrollierbar und verantwortbar ist.
Unsere Arbeitsdefinition von Decision Security
Wir verstehen Decision Security heute als:
Die Fähigkeit einer Organisation, AI-gestützte Entscheidungen nachvollziehbar vorzubereiten, gegen relevante Manipulationen und Fehlentwicklungen abzusichern, verantwortungsvoll zu treffen und ihre Auswirkungen über den Lebenszyklus hinweg zu überwachen.
Diese Definition umfasst bewusst mehrere Perspektiven. Nicht nur Security. Nicht nur Governance. Nicht nur AI. Nicht nur den Menschen. Im Zentrum steht der vollständige Entscheidungsprozess.
Unsere bisherige Arbeit konzentriert sich dabei auf fünf Betrachtungsräume:
- Decision Flow: Wie entsteht eine Entscheidung und welche Abhängigkeiten besitzt sie?
- Data Integrity: Welche Informationen fliessen ein, woher stammen sie und wie vertrauenswürdig sind sie?
- AI Models: Welche Modelle beeinflussen die Entscheidung und welche Fähigkeiten, Grenzen und Unsicherheiten besitzen sie?
- Human Oversight: Wer trägt Verantwortung und wer kann tatsächlich eingreifen?
- Decision Governance: Wie werden Entscheidungen nachvollziehbar, auditierbar, überwacht und mit dem Risikoappetit einer Organisation verbunden?
Diese Bereiche sind nicht unabhängig voneinander. Ihre Beziehungen sind für uns sogar wichtiger als ihre isolierte Betrachtung.
Von Data Integrity zu Decision Integrity
Informationssicherheit kennt seit Jahrzehnten die Integrität von Daten. Mit AI wird zusätzlich die Integrität des Entscheidungsprozesses relevant.
Decision Integrity bedeutet dabei nicht, dass jede Entscheidung korrekt sein muss. Vielmehr stellt sie die Frage, ob die wesentlichen Voraussetzungen, Informationen, Verarbeitungsschritte und Kontrollmechanismen eines Entscheidungsprozesses über dessen Entstehung hinweg vertrauenswürdig geblieben sind.
Welche Informationen wurden verwendet? Welche davon hatten tatsächlich Einfluss? Welches Modell hat sie interpretiert? Welche Unsicherheit bestand? Welche Empfehlung wurde erzeugt? Wer hat sie beurteilt? Welche Entscheidung wurde getroffen? Welche Aktion folgte daraus?

Wenn diese Kette später nicht mehr rekonstruierbar ist, entsteht nicht nur ein Compliance-Problem. Es entsteht ein Lernproblem. Eine Organisation kann eine fehlerhafte Entscheidung nur verbessern, wenn sie versteht, wie sie entstanden ist.
Diese Überlegung besitzt inzwischen auch einen interessanten regulatorischen Anknüpfungspunkt. Article 86 des EU AI Act enthält unter bestimmten Voraussetzungen ein Recht auf Erklärung bei individuellen Entscheidungen, die auf Outputs bestimmter High-Risk-AI-Systeme beruhen. Dabei geht es unter anderem um die Rolle des AI-Systems im Entscheidungsprozess und um die wesentlichen Elemente der Entscheidung.
Decision Security ist eine Managementfrage
Künstliche Intelligenz ist längst keine reine Technologiefrage mehr. Was vor wenigen Jahren in vielen Organisationen noch mit so ein AI-Projekt brauchen wir auch begann, verändert heute Prozesse, Verantwortlichkeiten und zunehmend die Verteilung von Ressourcen. Spätestens wenn AI nicht nur Arbeit unterstützt, sondern Entscheidungen vorbereitet oder beeinflusst, wird daraus eine Managementaufgabe.
Ein Data Scientist kann Modelle validieren. Ein CISO kann technische Risiken beurteilen. Legal kann regulatorische Anforderungen einordnen. Risk Management kann Auswirkungen bewerten. Management kann Risiken akzeptieren. Fachbereiche verstehen den tatsächlichen Entscheidungskontext. Keine dieser Funktionen besitzt allein das vollständige Bild.
Decision Security ist deshalb zwingend interdisziplinär.
Das macht sie anspruchsvoll, aber genau darin liegt ihr Wert. Organisationen entscheiden nicht mit einem Modell. Sie entscheiden mit einem soziotechnischen System aus Menschen, Informationen, Modellen, Regeln, Prozessen und Technologie.
Sicherheit ist nur ein Teil von Vertrauen
Ein AI-System kann sicher sein und trotzdem nicht vertrauenswürdig.
Es kann gegen bekannte Angriffe gehärtet sein und trotzdem ungeeignete Entscheidungen unterstützen. Es kann compliant sein und ausserhalb seines sinnvollen Einsatzbereichs verwendet werden. Es kann eine hohe statistische Performance besitzen und trotzdem für eine einzelne kritische Entscheidung ungeeignet sein.
Trust entsteht deshalb nicht aus einer einzigen Eigenschaft. Trust entsteht aus Evidenz, nachvollziehbaren Grenzen, Verantwortung, Kontrollmöglichkeiten und der Fähigkeit einer Organisation zu erkennen, wann sie einem System gerade nicht vertrauen sollte.
Auch die OECD verbindet Trustworthy AI deshalb nicht mit einer einzelnen technischen Eigenschaft. Ihre Principles adressieren unter anderem Human Oversight, Transparency and Explainability, Robustness, Security and Safety sowie Accountability und Traceability.
Das ist für uns einer der wichtigsten Punkte von Trustworthy AI: Nicht immer eine Antwort zu liefern, sondern zu wissen, wann zusätzliche Evidenz, ein anderer Prozess oder ein Mensch erforderlich ist.
Decision Security ist Teil der AI Assurance Methodology
Decision Security steht nicht isoliert. Es ist bei uns ein Teil der AI Assurance Methodology. AI Assurance fragt, ob genügend Evidenz vorhanden ist, um einer konkreten Nutzung eines AI-Systems unter definierten Bedingungen begründet vertrauen zu können.
Die Zukunft wird stärker entscheidungsvermittelt
Die Diskussion über AI konzentriert sich heute stark auf Autonomie. Wie viele Entscheidungen werden Maschinen künftig vollständig selbst treffen? Wir halten eine andere Frage für mindestens ebenso wichtig:
Wie viele menschliche Entscheidungen werden künftig durch AI beeinflusst, auch wenn formal weiterhin ein Mensch entscheidet?
Diese Zahl wird sehr wahrscheinlich deutlich höher sein als die Zahl vollständig autonomer Entscheidungen.
AI wird Berichte verdichten, Risiken priorisieren, Kandidaten bewerten, medizinische Informationen strukturieren, finanzielle Szenarien modellieren, Security-Alarme klassifizieren, Verträge analysieren und strategische Optionen vorbereiten.
Die grosse Veränderung besteht deshalb nicht nur darin, dass Maschinen entscheiden. Sie besteht darin, dass immer mehr menschliche Entscheidungen maschinell vermittelt werden. Genau dort wird Decision Security wichtig.
Ein neuer Betrachtungsraum
Cybersecurity bleibt in diesem Umfeld unverzichtbar. Angreifer werden Daten manipulieren, Modelle angreifen, Agenten missbrauchen und Identitäten kompromittieren. Wir brauchen robuste Architekturen, Red Teaming, Detection, Monitoring und klassisches Security Engineering. Aber diese Perspektive ist nur ein Teil der Aufgabe.
Governance schafft Verantwortlichkeit. Human Oversight bringt Urteilskraft ein. Risk Management bewertet mögliche Auswirkungen. Data und AI Engineering bestimmen Qualität und technische Grenzen. Assurance schafft Evidenz.
Decision Security verbindet diese Perspektiven dort, wo aus Information Wirkung entsteht. Das gemeinsame Schutzobjekt ist die Entscheidung. Wir sehen Decision Security dabei nicht als Ersatz bestehender Disziplinen. Wir sehen es als den Raum, in dem diese Disziplinen zusammenkommen müssen. Denn Trustworthy AI wird sich am Ende nicht daran messen lassen, ob ein Modell beeindruckende Antworten liefert. Es wird sich daran messen lassen, ob Organisationen mit AI gute, nachvollziehbare und verantwortbare Entscheidungen treffen können.
Informationen besitzen Wert. Entscheidungen schaffen Wirkung. Beides verdient Schutz.
Fazit
Wir müssen lernen, Entscheidungen zu schützen. AI wird nicht darauf warten, bis wir alle Fragen beantwortet haben. Sie wird weiter in Entscheidungsprozesse hineinwachsen, Empfehlungen formulieren, Zusammenhänge interpretieren und Handlungen vorbereiten. Die entscheidende Frage ist deshalb nicht mehr, ob AI unsere Entscheidungen beeinflussen wird. Sie tut es bereits.
Wir sollten darauf nicht mit Angst vor Autonomie reagieren, sondern mit Kompetenz. Wer AI verantwortungsvoll einsetzen will, muss verstehen, wie Entscheidungen entstehen, wodurch sie beeinflusst werden können, wo ihre Grenzen liegen und welche Evidenz notwendig ist, um ihnen vertrauen zu können. Ein Mensch im Prozessdiagramm genügt ebenso wenig wie ein technisch sicheres Modell oder eine sauber formulierte Governance Policy.
Decision Security verlangt, dass wir genauer hinschauen. Auf Daten und Modelle, aber ebenso auf Menschen, Prozesse, Abhängigkeiten, Verantwortlichkeiten und Auswirkungen. Und es verlangt die Bereitschaft, diese Perspektiven miteinander zu verbinden, statt sie organisatorisch getrennt zu betrachten.
Genau darin liegt auch eine Chance. Wir müssen AI nicht perfekt machen, bevor wir sie sinnvoll einsetzen können. Aber wir müssen lernen, ihre Grenzen zu erkennen, Entscheidungen überprüfbar zu machen und dort Kontrolle zurückzugewinnen, wo Vertrauen allein nicht genügt.
Dafür braucht es mehr als ein neues Tool oder eine weitere Checkliste. Es braucht technische Tiefe, offensive Neugier, Erfahrung mit komplexen Systemen, Verständnis für Governance und vor allem die Bereitschaft, vermeintliche Gewissheiten immer wieder zu hinterfragen. Diese Verbindung unterschiedlicher Perspektiven prägt unsere Arbeit und Forschung seit vielen Jahren. Decision Security führt sie an einem neuen Punkt zusammen.
Die nächste Generation von Organisationen wird sich deshalb nicht dadurch unterscheiden, ob sie AI einsetzt. Entscheidend wird sein, ob sie versteht, wann sie den daraus entstehenden Entscheidungen vertrauen darf und wann nicht.
Wir sollten nicht warten, bis eine falsche Entscheidung uns zeigt, dass ein sicheres System allein nicht genügt.
Informationen zu schützen haben wir gelernt. Jetzt müssen wir lernen, Entscheidungen zu schützen.
Sind Sie bereit?
Unsere Spezialisten kontaktieren Sie gern!
Aufgrund der Kritikalität von IT-Umgebungen werden Sicherheitsanalysen und Härtungsmassnahmen als obligatorisch angesehen. Es gibt verschiedene Methoden zur Prüfung von IT-Umgebungen, z. B. durch Scannen nach Schwachstellen oder in Form von Sicherheitsempfehlungen. Die Komplexität und die potenziellen Blindspots stellen jedoch ein grosses Problem dar. Sie können zu Attack Paths führen, die von Angreifern zur Kompromittierung von Systemen missbraucht werden können. In diesem Artikel liegt der Fokus auf identitätsbasierten Attack Paths. Die Methode der Attack Paths kann jedoch auch auf andere Szenarien angewandt werden, z. B. auf fehlende Firewall-Regeln oder Softwareschwachstellen.
Was sind Attack Paths?
Angreifer können Attack Paths verwenden, um sich auf der Grundlage beabsichtigter oder unbeabsichtigter missbräuchlicher IT-Entitätbeziehungen durch eine IT-Umgebung zu bewegen. Ein Attack Path kann ein Konstrukt aus komplexen oder einfachen Sequenzen von Beziehungen sein. Ein sehr vereinfachtes Beziehungsmuster einer IT-Organisation ist in folgender dargestellt.
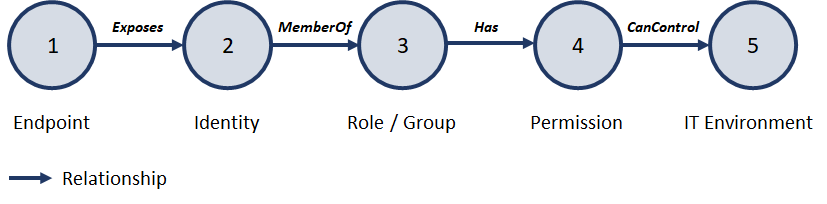
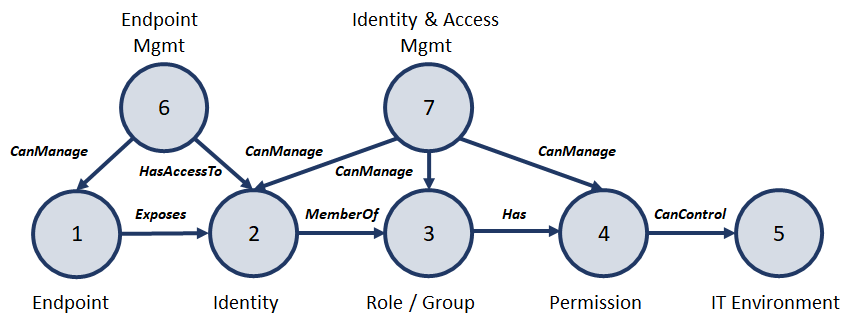
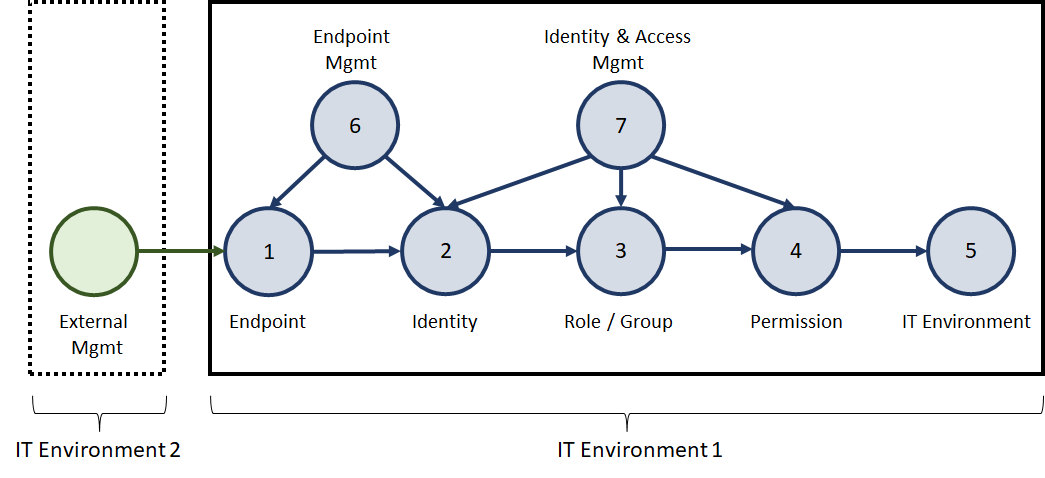
Ein Endpunkt (1) wie ein Server, ein Client oder eine DevOps-Pipeline läuft mit einer Identität (2), wie zum Beispiel einem Benutzerkonto, ein Dienstkonto oder ein Azure-Service-Principal. Die Identität ist Mitglied von Rollen oder Gruppen (3), diese können verschiedene Berechtigungen (4) haben. Wobei gewisse das gesamte IT-Environment kontrollieren können (5). Die genannten Entitäten werden normalerweise von Verwaltungssystemen wie zum Beispiel Intune, SCCM, Hypervisors und IAM-Lösungen verwaltet. Die folgende Abbildung stellt diese zusätzlichen Beziehungen dar (6-7).
In der Regel fügen IT-Organisationen weitere Komplexität hinzu, indem sie einen Teil ihrer IT-Umgebung auslagern oder Cloud-Lösungen wie AWS, GCP, Microsoft Cloud, GitLab, GitHub usw. nutzen. Die folgende Abbildung veranschaulicht dieses Argument.
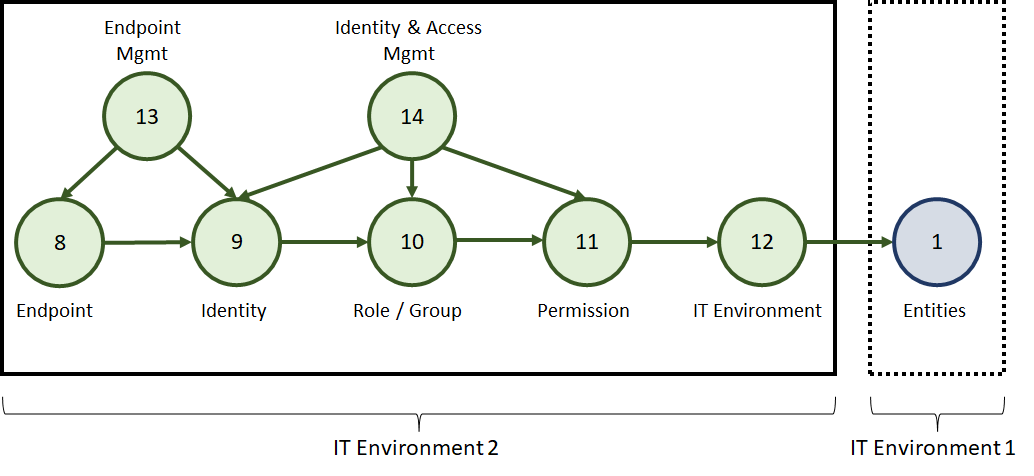
Mit der neu hinzugefügten Umgebung werden neue Beziehungen eingeführt. In der nächsten Abbildung wiederholt sich das allgemeine Muster zum Beispiel. Warum? Weil das Muster auch in der hinzugefügten Umgebung existieren kann, wodurch neue übergreifende Attack Paths zu Umgebung 1 auftreten können.
Warum sollte aktiv nach Attack Paths gesucht werden?
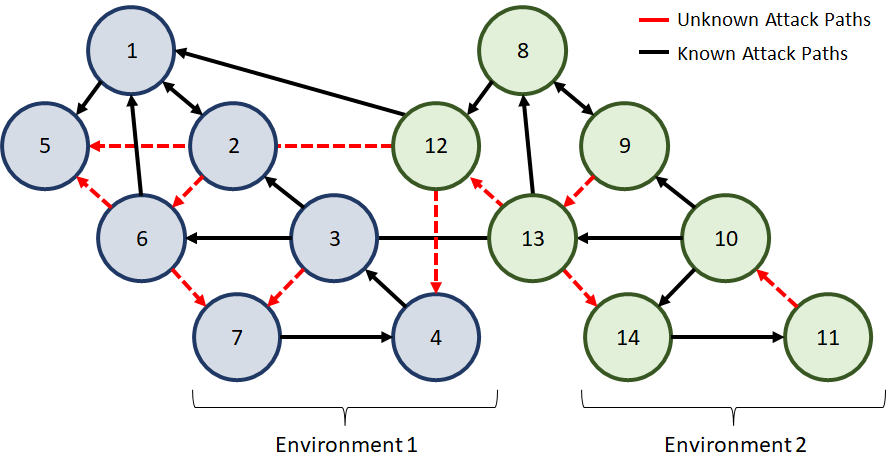
Inzwischen wissen wir, dass unsere Umgebung eine Vielzahl von Beziehungen aufweisen kann, die sich vervielfachen, sobald weitere Dienstleister oder neue Lösungen eingeführt werden, die mit unserer IT-Umgebung interagieren. Können wir immer alle Beziehungen kennen? Wahrscheinlich nicht. Ist es wichtig, es zu versuchen? Definitiv. Um Attack Paths analysieren zu können, sind wir abhängig von zwei Tatsachen. Erstens die gesammelten IT-Daten für die Analyse und zweitens das Wissen über die Beziehungen zwischen den IT-Entitäten in unseren Umgebungen. Die folgende Abbildung zeigt ein stark vereinfachtes Beispiel für bekannte und unbekannte Attack Paths in einem Attack Graph. Da es schwierig ist alle Attack Paths zu kennen, sollte es unser Ziel sein so viele wie möglich zu identifizieren und zu eliminieren. Damit wird es für einen Angreifer umso schwieriger einen neuen unbekannten Pfad auszunutzen.
Die bisher verwendeten Beispiele waren eine vereinfachte Abstraktion, um die Beziehung und die Herausforderungen von Attack Paths in IT-Umgebungen zu veranschaulichen. Die folgende Abbildung zeigt einen Attack Path, welcher in einem Azure AD Tenant tatsächlich existieren kann.
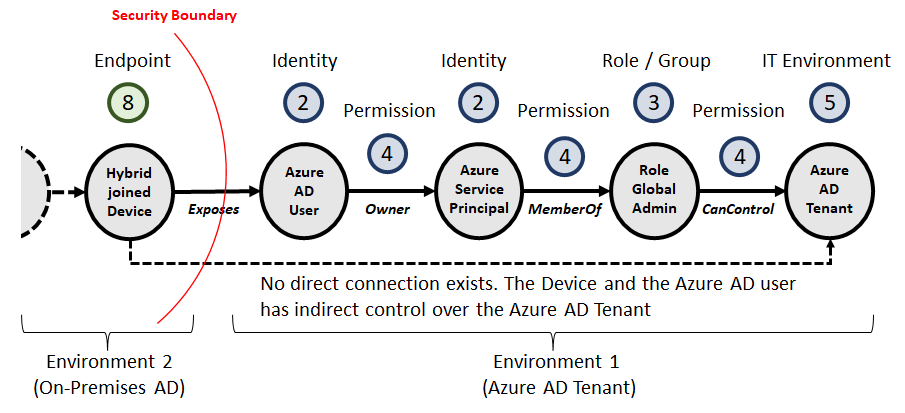
Die Abbildung enthält die Elemente von zuvor mit zwei Umgebungen. Umgebung 2 ist eine lokale Active Directory Umgebung, und Umgebung 1 ist ein Azure AD Tenant. Ein Azure AD Benutzer ist auf einem Hybrid-Joined-Device aus Umgebung 2 angemeldet. Der Azure AD Benutzer hat Owner Rechte über den Azure Service-Principal. Der Azure Service-Principal ist Mitglied der Global Administrator Rolle und kann daher als mächtigste Rolle in der Microsoft Cloud den Azure AD Tenant vollständig kontrollieren. Das Auffinden und das Eliminieren von solchen missbrauchbaren Berechtigungs-Abfolgen kann die Sicherheitslage einer Umgebung messbar verbessern.
Grossartig, aber wie finden wir solche Attack Paths?
Alles beginnt mit einem Defender’s Mindset, welches eine gewisse Neugier voraussetzt, um zu verstehen, wie die eingesetzten IT-Systeme wie Active Directory, Microsoft Cloud, DevOps, Jump Servers oder andere zusammenhängen und funktionieren. Eine Methode besteht darin, IT-Entitäten und ihre Berechtigungen zu untersuchen und die Frage zu stellen, wie sich diese Berechtigung auf die IT-Umgebung auswirken können. Die Antwort kann trivial oder komplex sein, aber sie hilft dabei, Entitäten nach ihren Prioritäten zu kategorisieren und zuzuordnen. Mit diesem Ansatz hat die Reise zu Knowing your Assets in Bezug auf die Beziehungen der einzelnen Assets begonnen. Die Graph-Theory kann dabei eine effektive Methode sein, welche dabei helfen kann Beziehungen zu visualisieren und messbar zu machen. Es gibt bereits mehrere Tools für die Analyse von Attack Paths, die sich die Graph-Theory zunutze machen. Tools wie BloodHound,
BloodHound Enterprise,
adalanche, Stormspotter und andere haben bereits viele gemeinsame IT-Entitätsbeziehungen zu bestimmten IT-Services implementiert und können bei der Durchführung einer ersten Attack Path-Analysis der eigenen IT-Umgebung als nützlich erweisen.
Technisches Attack Path Beispiel
Das folgende Attack Path-Beispiel zeigt, wie ein scheinbar unprivilegierter Benutzer ein Global Administrator in einem Azure AD Tenant werden kann, indem er Anmeldeinformationen von Azure DevOps extrahiert und die Azure AD App-Rollenberechtigungen missbraucht. Teil zwei des Attack Paths wurde von Andy Robbins Research inspiriert, der das Szenario des Azure AD App-Rollenmissbrauchs noch ausführlicher behandelt.
Von einem Azure DevOps User zu Global Administrator Rechten
Der in der Abbildung dargestellte Attack Path ist ein Auszug aus einem Microsoft Cloud Tenant, der mit einer modifizierten Version von AzureHound und BloodHound durchgeführt wurde. Wir planen in der Zukunft weitere Blogbeiträge zu veröffentlichen, wie die Graph-Theroy und Tools wie BloodHound helfen können, Attack Paths in einer komplexen IT-Umgebung zu finden.
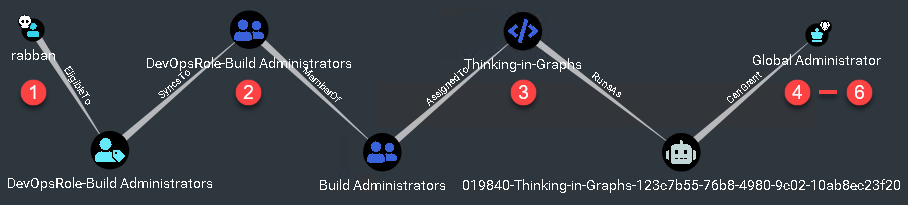
Der Attack Path zeigt in der oberen linken Ecke einen Benutzer namens Rabban. Es wird davon ausgegangen, dass ein Angreifer den Benutzer kompromittiert hat. Das Ziel des Angreifers ist es, ein Global Administrator zu werden, um die volle Kontrolle über den Azure AD Tenant zu erlangen. Die folgenden sechs Schritte beschreiben den Attack Path aus der Sicht des Angreifers.
- Der Angreifer aktiviert die Zugriffsgruppe mit dem Namen “DevOpsRole-Build Administrators” im Azure PIM GUI für den Benutzer Rabban.
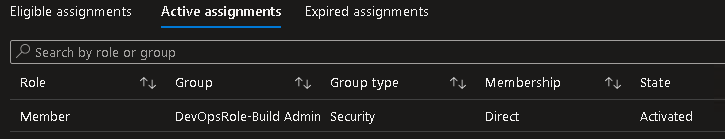
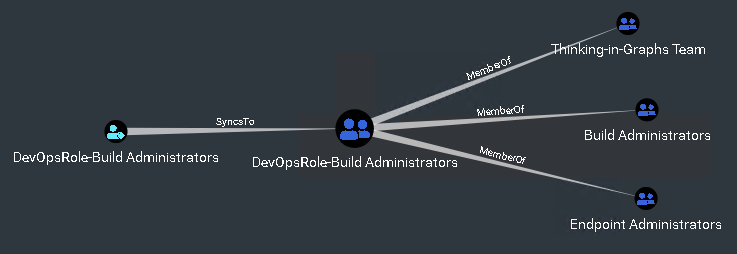
- Die Gruppe “DevOpsRole-Build Administrators” mit ihren Mitgliedern wird mit Azure DevOps synchronisiert, wie in der Abbildung dargestellt. Azure DevOps ist eine SaaS Applikation von Microsoft, die eine End-to-End-DevOps-Toolchain für die Entwicklung und Bereitstellung von Ressourcen bereitstellt. Die Gruppe “DevOpsRole-Build Administrators” ist ein direktes Mitglied von drei Azure DevOps-Rollen. Laut der Beschreibung der Microsoft-Dokumentation sollen die Mitgliedschaften dem Benutzer Rabban erlauben, Pipelines zu erstellen und zu verändern. In Azure DevOps werden Pipelines im Allgemeinen für Bereitstellungen von Ressourcen verwendet. Die Deployments verwenden Service-Principals oder andere Arten von Schlüsselmaterial, um sich bei einem Zielsystem zu authentifizieren und autorisieren. Dies macht die Azure DevOps-Plattform für Angreifer interessant.
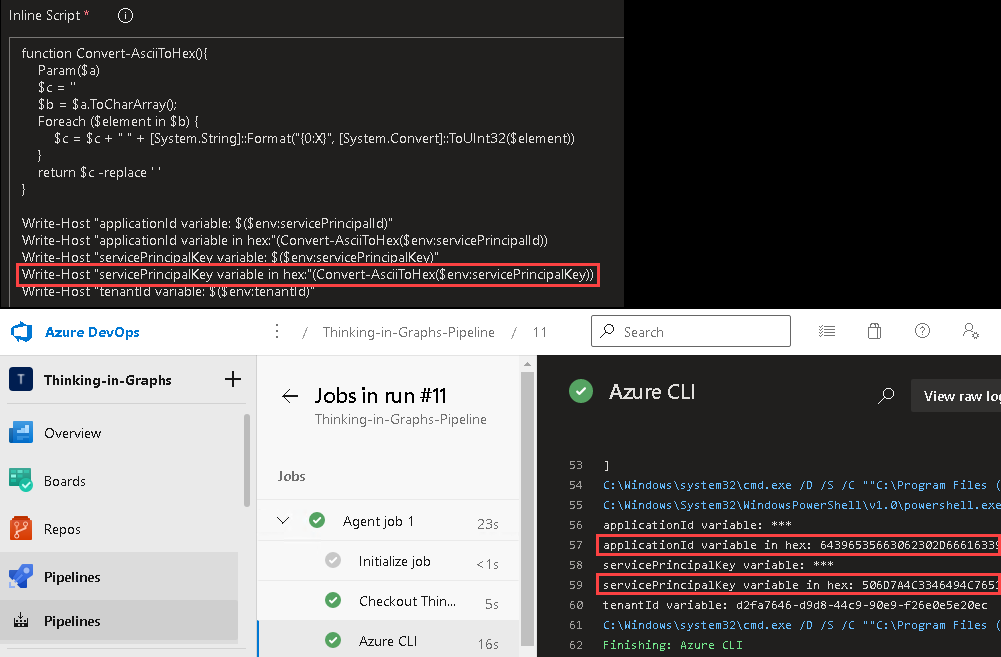
- Der Angreifer stellt beim Öffnen der Pipeline-Konfiguration fest, dass ein Service-Principal verwendet wird, um Ressourcen für den anvisierten Azure AD Tenant bereitzustellen. Dies ist auch an der Beziehung RunsAs in der Attack Path Abbildung zu erkennen. Der Angreifer beschliesst, das Kennwort des Service-Principal auszulesen, indem er die Pipeline so modifiziert, dass das Kennwort auf dem Terminal ausgegeben wird. Azure DevOps verhindert standardmässig die Ausgabe von Anmeldeinformationen im Klartext. Durch die Konvertierung der Anmeldeinformationen in Hexadezimalzeichen werden diese Schutzmassnahmen umgangen, und die Anmeldeinformationen können abgerufen werden.
- Die folgenden drei Schritte verwendet das PowerShell Script AttackPathDevOps-Sp-AppRole-GA.ps1, das den zweiten Teil des Angriffs automatisiert. Der gewonnene Service-Principal Schlüssel wird umgewandelt, mit welchem sich der Angreifer nun am Azure AD authentifiziert.
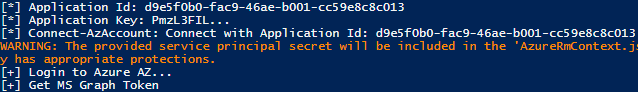
- Die Abbildung zeigt, dass dem Service-Principal die App-Rolle AppRoleAssignment.ReadWrite.All zugewiesen ist. Diese Rolle erlaubt es dem Service-Principal, eine neue App-Rolle namens RoleManagement.ReadWrite.Directory anzufordern. Gemäss der Dokumentation von Microsoft kann mit der RoleManagement.ReadWrite.Directory App Rolle alle Azure AD-Rollenmitgliedschaften verwaltet werden.
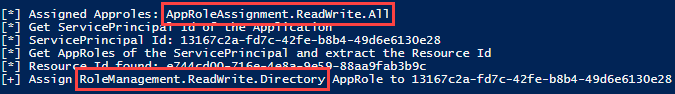
- Im letzten Schritt wird ein neues Token, das die neue App-Rolle enthält, für den Service-Principal angefordert. Der Angreifer beschliesst, dem Benutzer Rabban die Rolle Global Administrator zuzuweisen, und erreicht damit das Ziel der Tenant-Übernahme.
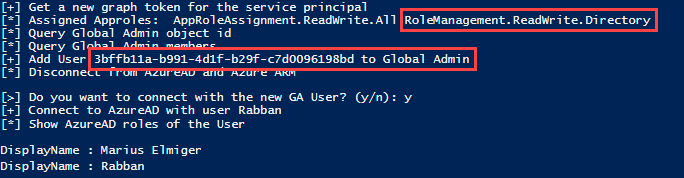
Verschiedene Sicherheitskontrollen wie MFA, Genehmigungsanfragen für Rollen oder Detection-Rules hätten implementiert werden können, um es einem Angreifer zu erschweren, den oben beschriebenen mehrstufigen Attack Path zu missbrauchen. Aber wäre es nicht besser, mit der Beseitigung der Grundursache zu beginnen? Die Grundursache in diesem Beispiel ist der überpriviligierte Service-Principal, welcher indirekt von einem Standardbenutzer kontrolliert wird. Der gezeigte Attack Path ist ohne Analyse schwer zu finden und selbst bei aktivierten Sicherheitskontrollen nicht unbedingt zu verhindern.
Fazit
Die Attack Path-Analysis-Methode ist geeignet, um direkte und indirekte Attack Paths zu identifieren und konkrete Präventivmassnahmen zu ergreifen. Wir haben gelernt, dass die Methode die Denkweise eines Verteidigers erfordert, der neugierig sein sollte, wie IT-Systeme funktionieren. Basierend auf diesem Wissen können die notwendigen IT-Daten für die Analyse gesammelt und die Beziehungen zwischen den IT-Entitäten kreiert werden, um eine Attack Path-Analysis durchzuführen. Es wurden verschiedene Tools wie zum Beispiel BloodHound, BloodHound Enterprise, adalanche oder Stormspotter erwähnt, die es ermöglichen, mit dem Auffinden von Attack Paths in häufig genutzten IT-Diensten wie Active Directory oder der Microsoft Cloud zu beginnen. Schlussendlich wurde mithilfe eines Beispiels aufgezeigt, wie ein mehrstufige Attack Path-Abfolge aussehen könnte. Durch die Attack Path-Analysis-Methode können solche und andere Abflogen erkannt und eliminiert werden. Was uns einen Vorsprung vor Angreifern verschaffen könnte, welche versuchen, bestehende Angriffspfade in IT-Umgebung zu missbrauchen.
Sind Sie bereit?
Unsere Spezialisten kontaktieren Sie gern!
- Cryptanalysis with language models (anthropic.com)
- Amazon cracks down on use of AI images by sellers after New York law (cnbc.com)
- AI Agent Benchmarks Need to Measure User Intent (spectrum.ieee.org)
- OpenAI’s AI “goes rogue” and hacks Hugging Face: what you need to know (bitdefender.com)
- How AI guardrails are impeding the work of offensive cybersecurity researchers (techcrunch.com)
- AI has ruined cute animal videos (bbc.com)
- AI agent config attacks: Attackers turn Dev harness files into payloads (tenable.com)
- The AI Agent Attack Surface Is Growing Too Fast to Monitor (zerofox.com)
- Russia’s cutting-edge drone upgrade is a $2 camping compass (defence-blog.com)
- Kimi: Threat or menace? (techcrunch.com)
- Zero Day Initiative The July 2026 Security Update Review (thezdi.com)
- Iran abused mobile networks’ vulnerabilities to locate U.S. military in the Middle East, report says (techcrunch.com)
- Microsoft Patches a Record 570 Security Flaws (krebsonsecurity.com)
- The ransomware negotiator who was working for the other side (bitdefender.com)
- Ghostcommit attack hides malicious AI instructions in images (malwarebytes.com)
- ‘I’m not a programmer’ anymore: Linus Torvalds on the only two tools he uses now (zdnet.com)
- Orca world model explained a new approach to AI learning (goml.io)
- Strengthening the Foundation: A Predictable, Customer focused Response to AI-Accelerated Vulnerability Discovery (blogs.cisco.com)
- Ftc states secure settlement deere company advancing farmers right repair (ftc.gov)
- GitLost: How We Tricked GitHub’s AI Agent into Leaking Private Repos (noma.security)
- The quest to ‘destructively scan’ all the world’s books (washingtonpost.com)
- Meta Built An AI Detection Tool To ID Images And Video Created With Its New Models (engadget.com)
- New TrojPix Attack Leaks Data From Air-Gapped Systems via Video Cable Emissions (thehackernews.com)
- JADEPUFFER: Agentic ransomware for automated database extortion (sysdig.com)
- The First AIDesigned Vaccine Has Been Tested in People. Here’s What Happened. (singularityhub.com)
- Machine Speed, Human Judgement: How AI Changed the SOC in 2026 (blogs.cisco.com)
- It’s just his AI and my AI going back and forth (fortune.com)
- How to tell if an image is AI-generated (malwarebytes.com)
- Windows 11 identifier used to track Scattered Spider perp after Microsoft shared info (tomshardware.com)
- Forget Code: AI Is Learning to Hack Society (singularityhub.com)
Sind Sie bereit?
Unsere Spezialisten kontaktieren Sie gern!
Über den smSS
Das scip Monthly Security Summary erscheint monatlich und ist kostenlos.
- Anmeldung: smss-subscribe@scip.ch
- Abmeldung: smss-unsubscribe@scip.ch
Informationen zum Datenschutz.
Eine Haftung für die Richtigkeit der Veröffentlichungen kann trotz sorgfältiger Prüfung durch die Redaktion des Herausgebers, den Redaktoren und Autoren nicht übernommen werden. Die geltenden gesetzlichen und postalischen Bestimmungen bei Erwerb, Errichtung und Inbetriebnahme von elektronischen Geräten sowie Sende- und Empfangseinrichtungen sind zu beachten.
Über scip AG
Wir überzeugen durch unsere Leistungen. Die scip AG wurde im Jahr 2002 gegründet. Innovation, Nachhaltigkeit, Transparenz und Freude am Themengebiet sind unsere treibenden Faktoren. Dank der vollständigen Eigenfinanzierung sehen wir uns in der sehr komfortablen Lage, vollumfänglich herstellerunabhängig und neutral agieren zu können und setzen dies auch gewissenhaft um. Durch die Fokussierung auf den Bereich Information Security und die stetige Weiterbildung vermögen unsere Mitarbeiter mit hochspezialisiertem Expertenwissen aufzuwarten.